


本文转自《收视中国》ID:shoushizhongguo
搜索时代,用户在千万条结果里自己淘金;AI问答时代,大模型完成信息整合与交叉验证环节,直接向用户输出结构化的决策参考。根据Adobe 2026年3月针对美国零售场景的监测数据,来自AI渠道的引流用户转化率较传统非AI流量高出42%。这一数据的意义并不局限于新渠道的短期流量红利,更折射出品牌传播竞争逻辑的关键迁移——用户不再为“被看见”停留,而为“被采信”转化。当AI成为人与信息之间的新界面,主流媒体历经长期沉淀所积累的公信力正在系统性重估。
入口之变:注意力稀缺,正在让位于判断力稀缺
CNNIC《生成式人工智能应用发展报告(2026)》显示,截至2026年上半年,我国生成式AI用户规模突破7亿,76.0%的用户最常用场景是“让AI回答问题”。
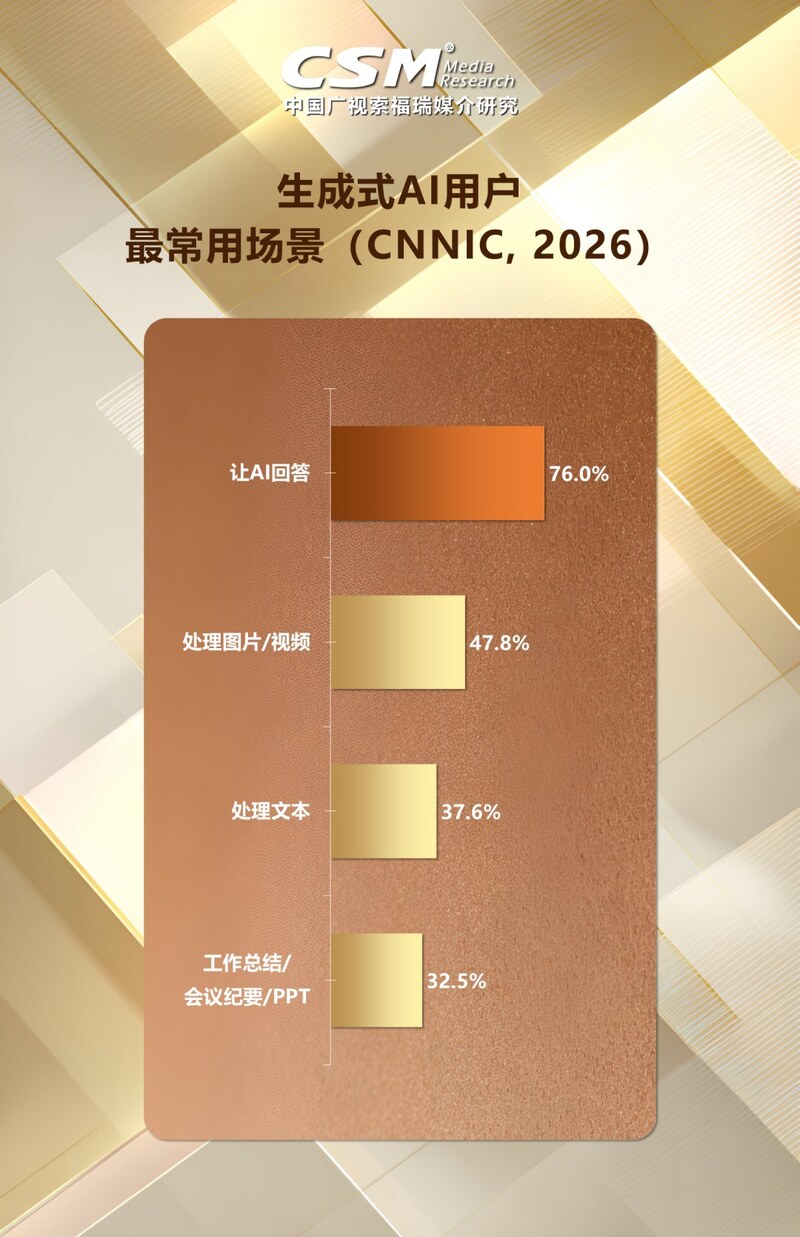
信息入口正在从搜索框聚合为对话框,信息筛选权被整体外包给AI。诺贝尔经济学奖得主西蒙1971年那句“信息的富足造成注意力的贫乏”,解释了整个流量时代;而今天,注意力稀缺正在让位于判断力稀缺——不是没人看,而是没人能判断该看什么。
对品牌而言,更深的位移在于叙事控制权。Semrush 2026年AI Visibility Index分析了1.26亿条美国AI搜索提示,结论显示:品牌在AI答案里的样子,一半不归品牌自己管,AI平台理解品牌,依赖的是媒体报道、社区讨论、独立出版商这些品牌控制之外的信息生态。
入口聚合之处,即权力重构之处。问题随之而来:决定品牌能否进入答案、以什么形象进入答案的关键变量,是什么?
机器之限:AI是加工厂,不是源头
答案藏在AI自身的结构性短板里。这些短板不是阶段性bug,而是概率生成范式的底层属性。
其一,AI不能生成事实,只能加工存量。Mozilla基金会调研显示,全球约64%的大语言模型以Common Crawl公共网页库为训练底座,所有模型都用同一批原料投料生产,输出必然向全网统计均值收敛。2024年,牛津大学、剑桥大学等团队发表于《自然》的“模型坍塌”研究进一步提出:如果AI大量递归使用自身生成的内容训练下一代模型,输出的多样性会逐代衰减,最终丢失真实世界的长尾信息,陷入同质化的坍缩。
其二,AI不能自我核验,必须依赖外部信源。最有意味的证据来自尼曼新闻实验室(Nieman Lab)的一项分析:ChatGPT在回答中频繁生成指向《纽约时报》、BBC、《卫报》的链接,但相当比例是404,模型“幻觉”出了指向权威媒体的引用。机器想引用权威,却未必真的读了权威,这恰恰证明,权威媒体是它认知里的可信度锚点。普林斯顿大学发表于ACM SIGKDD的GEO研究给出了实证:添加引用、统计数据、专家引语,可以让信源在AI回答中的可见度提升30%—40%。可见,可信度是AI的内置排序逻辑,也是AI传播的硬通货。
其三,AI不能承担责任。一条AI生成的错误信息,没有任何主体为它负责;一条署名报道出错,记者、编辑、机构构成完整的责任链条。责任是信任的抵押物——没有署名的内容,是一纸没有抵押的承诺。这不是技术问题,是制度设计,信任只生长在可追责的土壤上。
其四,AI不能生产独家。AI可以整合已知,不能挖掘未知;可以模仿风格,不能伪造在场。广西日报特稿《王的猜想》是最佳佐证:菲尔兹奖得主话题刷屏时,AI账号批量产出同质化稿件,这篇特稿采访13人、挖出大量未公开信息,晚发一天,反而赢得口碑,因为AI加工的是存量,源头生产的是增量。
效率可以量产,事实不能。AI答得越快,源头越值钱。
媒体之重:AI的能力边界,主流媒体的价值锚点
AI时代主流媒体的价值,不是一个笼统的“公信力”,而是一组与AI能力边界精确对应的能力资产。
第一重:一手记录
机器可以模仿任何风格,唯独无法生成“真实发生过”。以体量最大的中央广播电视总台(下称“总台”)为例,超300万小时音像资料馆的储备,大多是对现实世界的原生记录而非二次虚构;一线采编网络持续产出的独家素材。在信息链的分工里,源头永远处于最上游——每一个AI答案,最终都需要一个源头。
第二重:可核验信源
AI公司为权威信源开出数十亿美元支票,这不是版权交易,是给“可信度”明码标价。OpenAI与新闻集团签署五年期内容授权、总金额超2.5亿美元;《纽约时报》与亚马逊达成AI内容合作,年度授权费用达2000万至2500万美元。当AI公司集体抢购权威媒体,它们抢的不是内容,是模型不可或缺的地基。
第三重:署名主体
署名深度报道能撑起百万级付费订阅,AI批量生成的资讯却很难收取直接用户付费溢价——定价差从来不在信息密度,核心是内容背后的责任绑定强度。
第四重:专业体系
同质化的解药,不是更快的生成,而是更深的差异。职业采编的事实核查、多平台交叉印证、专家深度解析,构成AI均值化输出的反面。
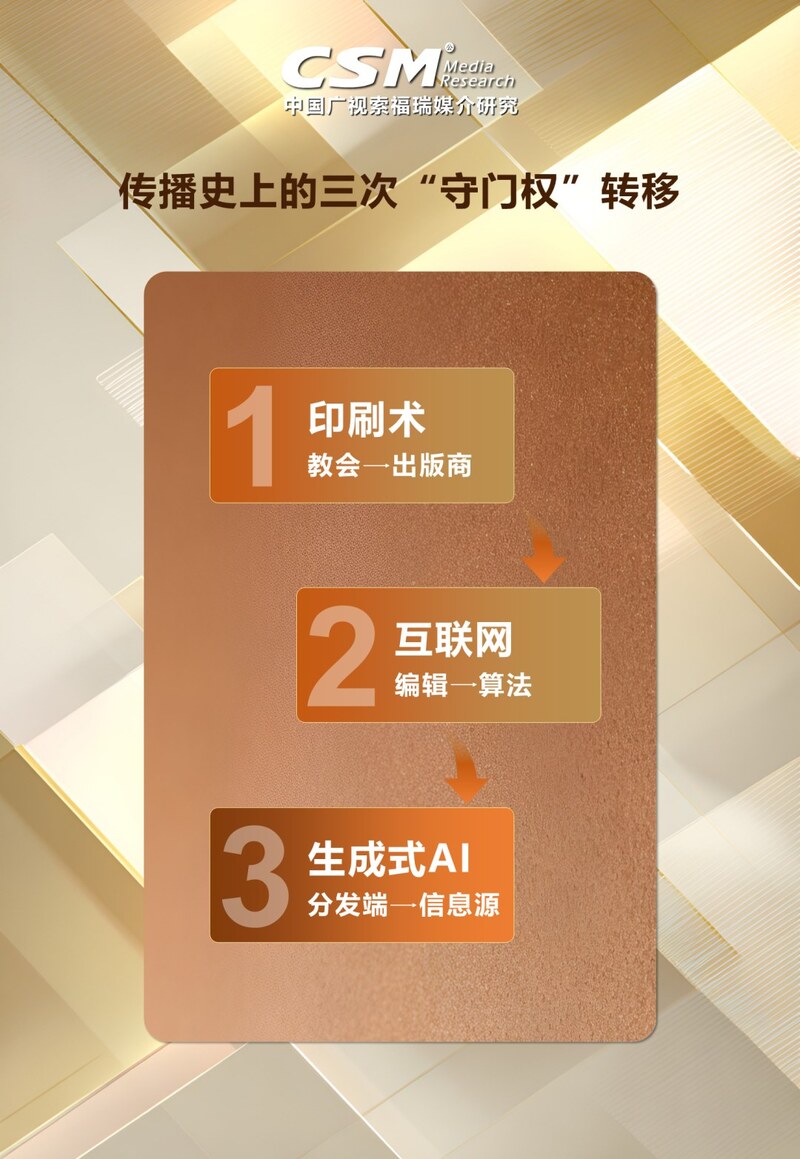
传播史上的守门权转移过两次:印刷术把它从教会交给出版商,互联网把它从编辑交给算法——主流媒体两次都让出了守门权。而AI带来的第三次转移方向恰好相反:生成模型的质量根基系于训练信源,守门权从“分发端”回到了“信源端”。
营销之变:权威媒体是唯一“复利型媒介”
守门权回到信源端,最先要重写的,是品牌的传播账本。
传统公关的价值评估体系正面临双重失效。一方面,发稿量不再等于信任。在AI的知识生产链路中,未被模型引用的稿件,其传播价值仅停留于当期曝光,本质上是一笔沉没成本;唯有被结构化采信的核心事实,才会在持续的问答调用中转化为稳定的信任资产。因此,传统公关以发稿量、转载量为核心的KPI体系需要被重写——新的评估坐标是:品牌的核心事实以何种结构、沉淀于哪些可信信源。另一方面,舆情风险由显性转向隐性。传统舆情具有可监测、可响应、可处置的特征,而AI舆情是错误语料被模型静默收录、静默输出,品牌察觉时往往已固化为问答结果的一部分。更关键的是,大模型不具备遗忘机制,多年前已平息的负面事件会在后续每一次相关提问中被重演。这意味着删稿逻辑已告失效,品牌声誉管理必须从“事件处置”转向“语料治理”,通过持续、权威的事实供给,实现对错误语料的稀释与覆盖。
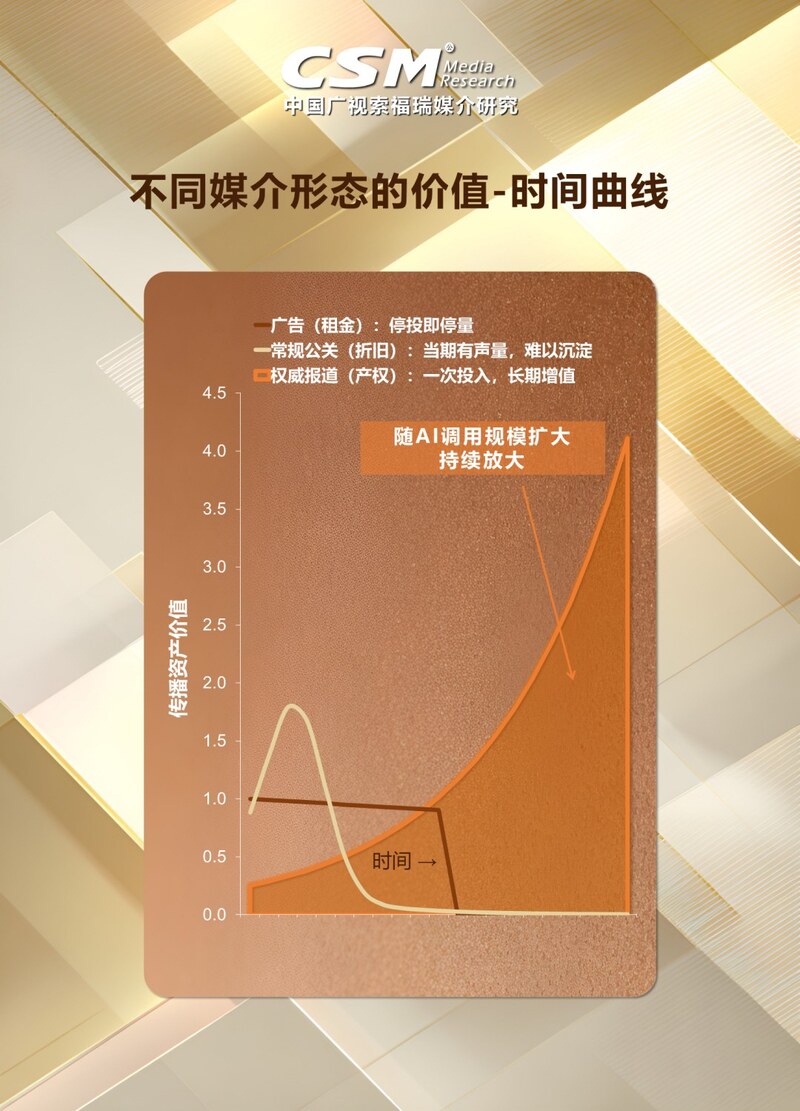
在这一背景下,权威媒体的传播价值被重新定价。一则权威报道同时产出三重效应:品牌提及、可信度信号、可被机器抓取的结构化语料。这是其他媒介形态无法提供的复利结构——广告是租金,停投即停量;常规公关是折旧,当期有声量但难以沉淀;权威报道则是产权,一次投入、长期增值,且其第三重效应会随AI调用规模的扩大而持续放大。国家级语料库的意义正在于此:它并非又一条信息发布渠道,而是为所有冲突信息提供最终参照系,构成品牌在机器世界中的信用锚点。
上述逻辑正在被系统化落地。总台于2026年10月启动、2027年1月上线的“国家品牌可信语料平台”,是中国市场对这一范式的规模化实践。平台下设品牌事实库、内容资产库、公共证据库、品牌问答库四大板块,完整覆盖品牌可信度的四个语法维度——身份、履历、证据、应答。
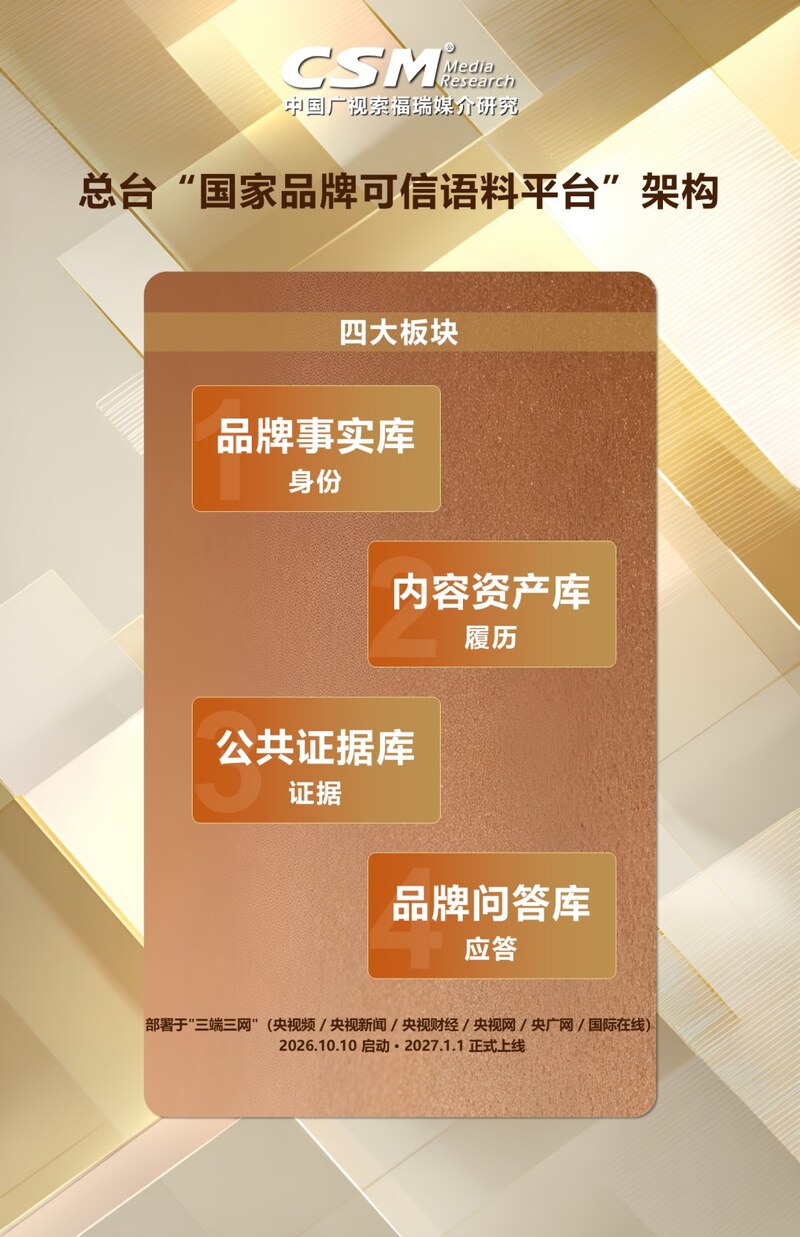
其突破性在于:一是三端三网公网开放,语料定位为供整个AI生态调用的公共基础设施,而非封闭库存;二是广告审核“明厨亮灶”,把关人机制诞生七十年来首次从后台职业操守转化为可交付的可信产品,审核过程本身成为品牌信用的佐证语料;三是以超300万小时动态音像资料叠加品牌强国工程八年内容积淀,为品牌建立起机器可读的信用档案。品牌把信用存进国家平台,标志着投入首次脱离营销费用的即时消耗属性,真正具备了可确权、可沉淀、可增值的长期品牌资产价值。
上一个时代,媒体为品牌赢得注意力;AI时代,媒体为品牌赢得机器的信任。注意力会衰减,信任会复利;流量可以采买,源头无法速成。主流媒体在智能时代不只是分发渠道,而是机器信用的最深源头。
责任编辑:凌美
24小时热文
流 • 视界


专栏文章更多
- [常话短说] 【重磅】国产算力加持,广电4K剪辑效率提升70%! 2026-10-23
- [探显家] 从Uber到PubMatic:Megan Ramm带不走的那张牌 2026-10-23
- [常话短说] 【重要信号】“十问”国家数据集团! 2026-10-22
- [常话短说] 【解局】他一审被判十二年! 2026-10-21
- [常话短说] 【解局】守住广电的基本盘! 2026-10-20
